Harun Seyhan stellt NVIDIA Nemotron 3.5 Transcribe im Überblick über neue offene Modelle kurz vor. Der Kanal nennt Transkription, Sprecherzuordnung und Übersetzung als Aufgaben desselben Modells.
Ein Modell für aufgezeichnete Sprache
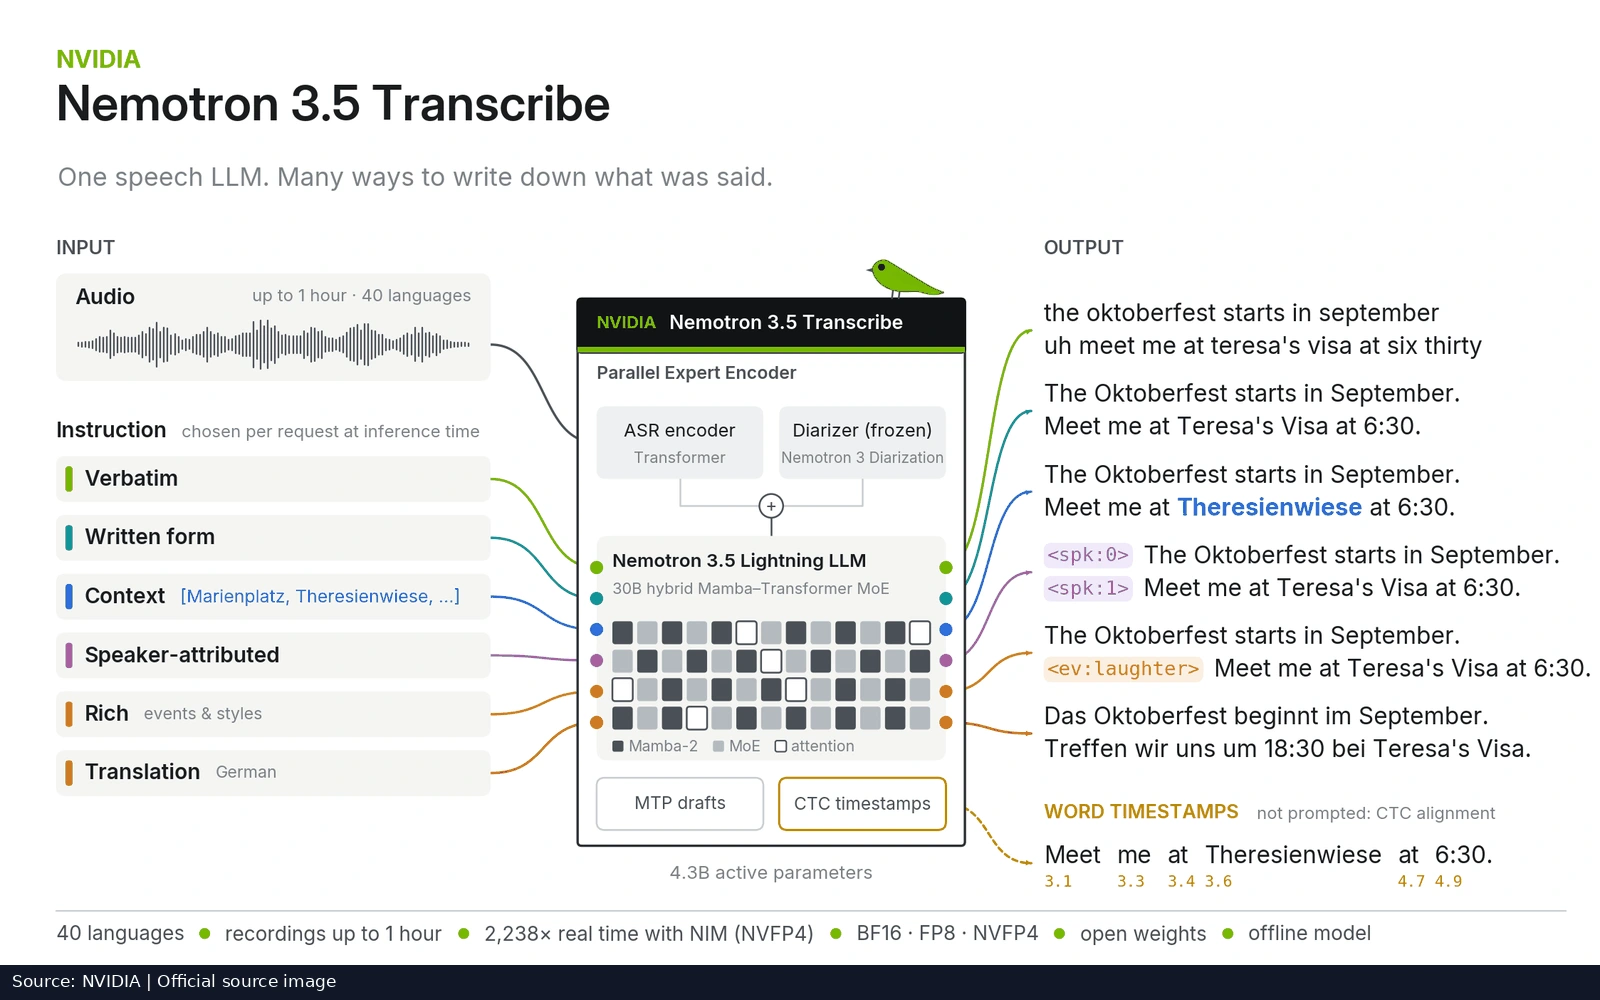
NVIDIAs Veröffentlichung vom 28. Oktober beschreibt ein offenes Sprachmodell, das sich durch natürlichsprachige Anweisungen steuern lässt. Es kann wortgetreue oder besser lesbare Transkripte liefern, Sprecherinformationen zuordnen und Zeitmarken für Wörter ergänzen.

Das System unterstützt 40 Sprachen. Übersetzung gehört zu derselben Modellfamilie; Sprecherzuordnung und Transkription müssen damit nicht als voneinander getrennte Produkte behandelt werden.
Offene Gewichte und Offline-Verarbeitung
Die technische Dokumentation beschreibt die Offline-Verarbeitung von Aufnahmen, keinen Echtzeit-Streaming-Erkenner. NVIDIA veröffentlicht die Gewichte unter OpenMDW-1.1 und stellt ein Werkzeugpaket zur Feinabstimmung bereit.
Der kurze Videoüberblick konzentriert sich auf die Sprachaufgaben. Die Dokumentation enthält zusätzlich die Einzelheiten zu Checkpoints, Bereitstellung und Sprachunterstützung für die Integration in Anwendungen.