Zyphra Hierarchical Attention, kurz ZHA, soll das Auffinden wichtiger Informationen in sehr langen KI-Kontexten effizienter machen. Die hohen Geschwindigkeitszahlen für Millionen und Milliarden Token stammen allerdings aus einem Leistungsmodell und sind keine gemessenen Laufzeiten einer vollständigen Anwendung.
Ein Baum statt einer flachen Suche
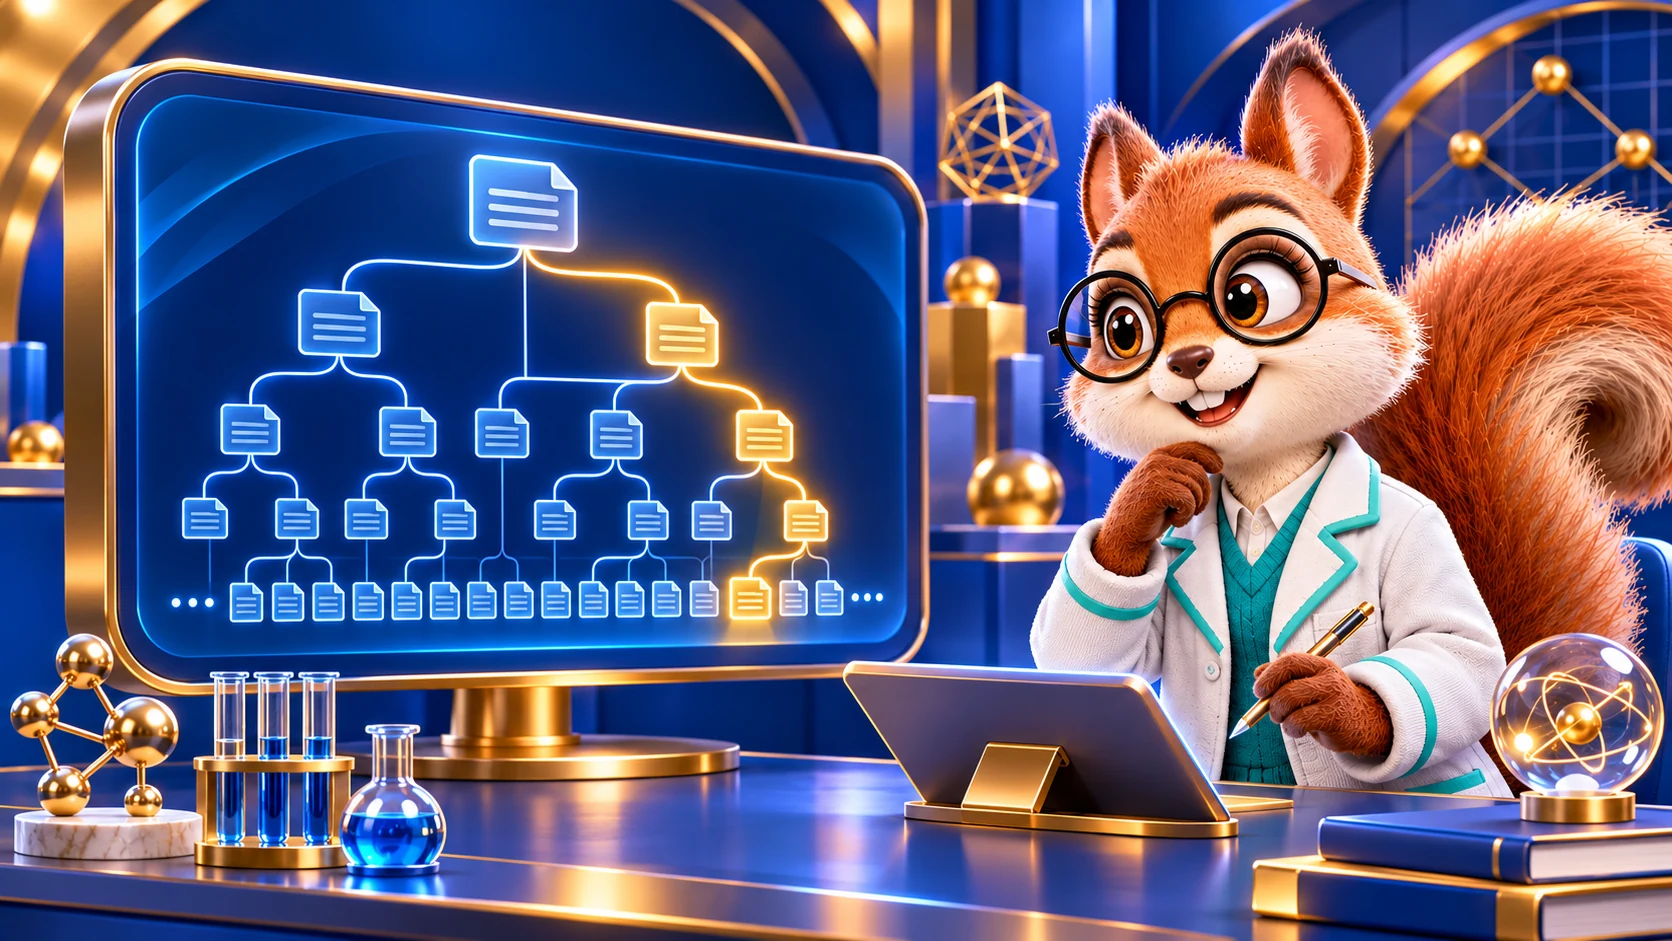
In seiner Erklärung vom 2. November beschreibt Zyphra eine Baumstruktur aus verdichteten Zusammenfassungen früherer Informationen. Bei einer neuen Anfrage werden aussichtsreiche Zweige geöffnet und nur ausgewählte Einträge genauer berücksichtigt. Das ähnelt der Suche über Inhaltsverzeichnis und Kapitel, bevor man eine bestimmte Stelle liest.
Wenn eine Frage Informationen aus mehreren entfernten Stellen braucht, kann das Verfahren mehrere Zweige öffnen. Der vollständige Cache bleibt auf der untersten Ebene erhalten; die Auswahl ist daher nicht auf eine fest vorgegebene Größe beschränkt.
Versuchsergebnisse und Hochrechnungen
Das Team passte ein bereits vortrainiertes Modell an: Seine Gewichte blieben eingefroren, während eine kleine Suchkomponente trainiert wurde. Verglichen wurden Ergebnisse unter anderem bei Informationssuche, logischem Denken und Programmieraufgaben. Daraus folgt nicht, dass die Geschwindigkeiten für extreme Kontextlängen bereits in einem Produkt gemessen wurden.
Das GPU-Leistungsmodell von Zyphra prognostiziert bei zehn Millionen Token eine etwa 32- bis 35-fach schnellere Attention als die dichte Variante und bei einer Milliarde Token etwa das 373- bis 417-Fache. Die Schätzung betrifft diese Berechnung unter den Modellannahmen, nicht die gemessene Gesamtlaufzeit einer Anwendung.