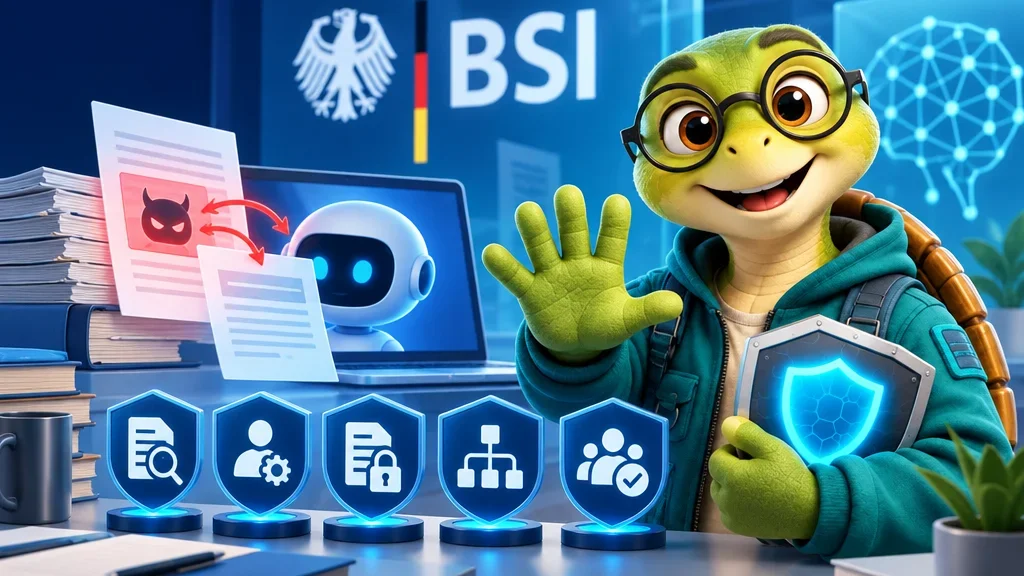
Subes un contrato, una factura o un PDF largo a un chat de IA y pides un resumen. El archivo parece inofensivo. Pero en algún lugar, en texto blanco sobre fondo blanco o en caracteres Unicode invisibles, hay una instrucción dirigida al modelo, no a ti. Ese es el escenario que aborda la Oficina Federal de Seguridad de la Información de Alemania (BSI) en una nueva guía.
¿Qué es una inyección indirecta de prompts?
Un prompt es la entrada que recibe un modelo de lenguaje para generar una respuesta. En una inyección directa, el atacante escribe él mismo la instrucción maliciosa en el chat. En una indirecta, los papeles están separados: la instrucción llega desde una fuente externa que el modelo procesa, como un documento, una página web o un correo, y quien chatea es otra persona. Según la BSI, el contenido no es solo el texto visible: también cuentan los metadatos, las anotaciones y los comentarios. Las consecuencias típicas de un ataque con éxito son fugas de datos, la revelación del prompt del sistema o una tarea mal ejecutada.
Qué ha publicado la BSI y para quién
La versión 1.0 de «Basisschutz gegen Indirect Prompt Injections in dokumentbasierten LLM-Chats» lleva fecha del 14 de septiembre de 2026. Está dirigida a quienes operan aplicaciones de chat que analizan documentos subidos. La BSI la elaboró a partir de pruebas de red teaming en varios de estos chats, es decir, intentos deliberados de provocar fallos en los sistemas. La debilidad que se repetía: el contenido del documento entraba en el prompt sin filtrar y sin separarse con claridad de la petición del usuario. Entre los hallazgos más críticos estaban las fugas de datos mediante enlaces de exfiltración. Junto al documento, la BSI ofrece un repositorio en GitHub con las medidas y una skill de agente que comprueba si una aplicación de chat las ha aplicado.
Las cinco medidas básicas
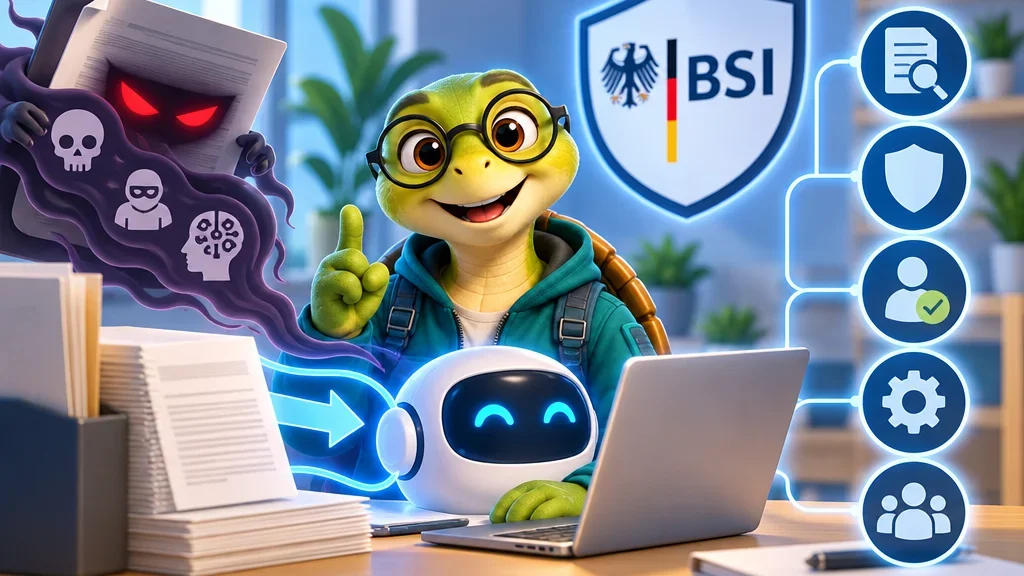
Primera, la limpieza de la entrada: antes de que el texto extraído llegue al modelo, se neutralizan caracteres ocultos, letras de aspecto similar y marcadores de rol falsos. Segunda, la separación de zonas de confianza: el documento se envuelve en bloques claramente etiquetados con un identificador aleatorio por petición, para que un atacante no pueda cerrar el bloque sin más. Tercera, un prompt del sistema reforzado que no concede al documento autoridad para dar instrucciones e incluye un token canario secreto. Cuarta, la elección del modelo y el razonamiento: los modelos robustos con un paso previo de reflexión detectan con más frecuencia los ataques camuflados en el lenguaje; la BSI considera el razonamiento una de las palancas más eficaces. Quinta, un filtro de salida revisa la respuesta final, por ejemplo si se filtran el token canario o partes del prompt del sistema.
¿Por qué no hay una solución completa?
Un modelo de lenguaje percibe la petición del usuario, las instrucciones del sistema y los datos del documento como una única cadena de tokens. Ya en su aviso de 2023, la BSI afirmó que no se conocía ninguna contramedida fiable que no limitara también de forma notable la funcionalidad. El nuevo documento recuerda que incluso las defensas diseñadas a propósito pueden sortearse con ataques adaptativos y subraya que las medidas no sustituyen un red teaming específico de cada aplicación ni una evaluación de seguridad individual.
¿Qué significa si la IA lee tu correo o navega por ti?
El aviso de 2023 también propone medidas para aplicaciones que actúan: limitar las acciones y los plugins de un asistente a lo que necesita la tarea, exigir autorización humana antes de acciones potencialmente críticas, preferir acciones reversibles o un entorno aislado (sandbox) y evitar en lo posible fuentes no fiables. Además, advierte de que un chatbot manipulado puede argumentar de forma convincente por qué conviene aprobar una acción.
Nuestra valoración
El documento está pensado para desarrolladores, pero su lógica sirve también en el día a día. Si un asistente puede leer tu bandeja de entrada y además enviar correos, la petición de confirmación no es un trámite: es justo el paso que recomienda la propia BSI. Nuestra conclusión: si el asistente explica con insistencia por qué algo es urgente, esa explicación no es una prueba. Comprueba de dónde salió la petición y luego decide. Las medidas dificultan los ataques, no los hacen imposibles, y la BSI lo dice abiertamente.