Si calculas el presupuesto de un proyecto de IA con la lista de precios, Claude Fable 5.2 parece un ahorro. La tabla de precios de Anthropic indica 8 dólares por millón de tokens de entrada y 40 dólares por millón de tokens de salida, frente a los 10 y 50 dólares de Fable 5.1. Es un 20 por ciento menos por token. La empresa independiente de evaluación Artificial Analysis mide otra cosa: en el nivel de esfuerzo Max, una tarea de su Intelligence Index cuesta 26,54 dólares con Fable 5.2 y 12,99 dólares con Fable 5.1 en ese mismo nivel. El precio por token ha bajado y la factura por tarea se ha duplicado aproximadamente.
Por qué ha subido el coste por tarea
La explicación está en cuánto escribe el modelo. Un token es la pequeña unidad de texto que un modelo lee y produce, y se factura cada uno. Según las páginas de modelos de Artificial Analysis, Fable 5.2 en Max generó 275 millones de tokens de salida para completar el índice. Fable 5.1 en Max necesitó 163 millones, y la mediana de los modelos comparables es de 72,8 millones. Un descuento del 20 por ciento por token no compensa unos dos tercios más de salida.
A cambio obtienes la mejor puntuación. Fable 5.2 en Max alcanza 65 puntos y ocupa el primer puesto de 74 modelos; la mediana es 40 y Fable 5.1 en Max obtuvo 49. En coste por tarea, la misma configuración ocupa el puesto 73 de 73.
Qué mide el «coste por tarea»
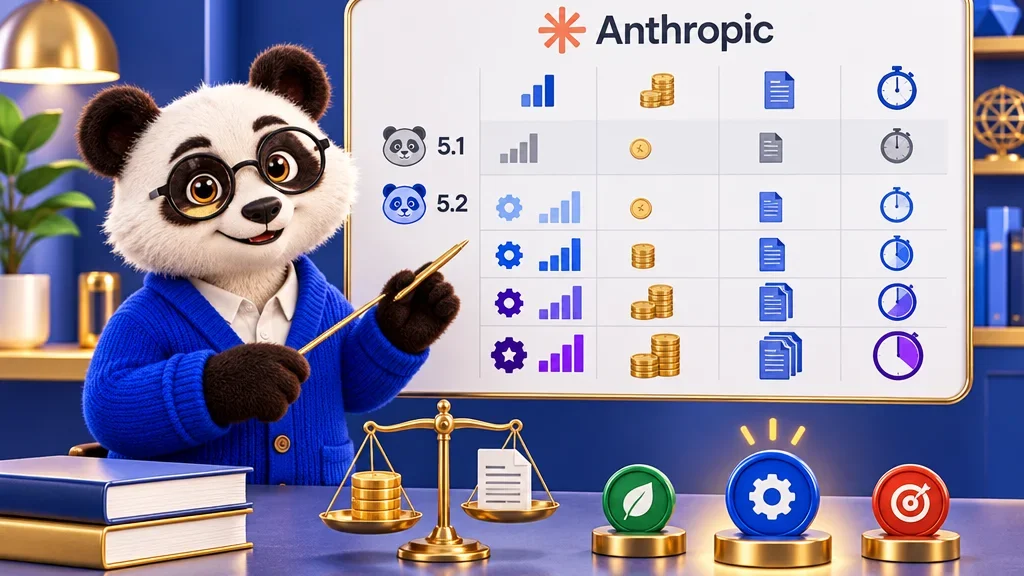
Artificial Analysis describe la cifra como una media ponderada. Para cada evaluación del índice, el coste se calcula a partir de los precios de los tokens (entrada, aciertos de caché, escrituras de caché, razonamiento y respuesta), se divide entre el número de tareas y después se pondera según el peso de esa evaluación en el índice. Los tokens de razonamiento cuentan, así que un modelo que piensa más tiempo cuesta más aunque su respuesta final sea breve.
Es un coste de tareas de evaluación a precios de API. Tus propias tareas pueden ser más ligeras o más pesadas. Por eso conviene leer la cifra como una comparación entre modelos y ajustes en las mismas condiciones, y no como una previsión de tu factura.
Cómo cambia la factura según el nivel de esfuerzo
El esfuerzo es el ajuste que determina cuánto razona el modelo antes de responder. Artificial Analysis publica Fable 5.2 por separado para cada nivel, y las diferencias son grandes. En Medium, el modelo obtiene 56 puntos por 3,80 dólares por tarea y tarda 8,1 minutos por tarea. En High obtiene 62 puntos por 9,08 dólares y 17,5 minutos. En xhigh la puntuación se queda en 62, mientras el coste sube a 14,83 dólares y el tiempo a 26,1 minutos. Max ofrece 65 puntos por 26,54 dólares y 44,4 minutos por tarea. El modelo mediano necesita 12,8 minutos, y Fable 5.1 en Max tardaba 22,5.
Nuestra valoración: empieza en High y justifica Max
Lo que sigue es nuestra lectura de estas cifras, no una afirmación de ninguna de las dos fuentes. High ofrece 62 de los 65 puntos por cerca de un tercio del coste de Max y en bastante menos de la mitad del tiempo. Para la mayoría de los trabajos es el punto de partida razonable. Medium es la opción económica para tareas rutinarias: con 56 puntos sigue en el noveno puesto de 74 modelos, por menos de la mitad del coste de High.
En este índice, xhigh añade coste y tiempo de espera respecto a High sin añadir puntos, así que solo lo usaríamos si tus propias pruebas muestran una diferencia. Max tiene sentido cuando un problema es tan difícil que tres puntos más en el índice compensan casi el triple del coste de High. Elige el que encaja, no solo el más grande.
Hay un límite que vale para todo lo anterior: es un único benchmark con su propia mezcla de tareas. Si tu trabajo es distinto, ejecuta una muestra pequeña en dos niveles de esfuerzo y compara los resultados antes de fijar un presupuesto.