Wenn du ein KI-Projekt nach der Preisliste kalkulierst, wirkt Claude Fable 5.2 wie eine Ersparnis. Anthropics Preistabelle nennt 8 US-Dollar pro Million Input-Token und 40 US-Dollar pro Million Output-Token, nach 10 und 50 US-Dollar bei Fable 5.1. Das sind 20 Prozent weniger pro Token. Das unabhängige Benchmark-Unternehmen Artificial Analysis misst etwas anderes: In der Effort-Stufe Max kostet eine Aufgabe seines Intelligence Index mit Fable 5.2 26,54 US-Dollar, mit Fable 5.1 in derselben Stufe 12,99 US-Dollar. Der Preis pro Token ist gesunken, die Rechnung pro Aufgabe hat sich ungefähr verdoppelt.
Warum die Kosten pro Aufgabe gestiegen sind
Die Erklärung liegt in der Menge, die das Modell schreibt. Ein Token ist die kleine Texteinheit, die ein Modell liest und erzeugt, und jedes einzelne wird abgerechnet. Laut den Modellseiten von Artificial Analysis hat Fable 5.2 in der Stufe Max 275 Millionen Output-Token erzeugt, um den Index zu durchlaufen. Fable 5.1 brauchte in der Stufe Max 163 Millionen, der Median vergleichbarer Modelle liegt bei 72,8 Millionen. Ein Rabatt von 20 Prozent pro Token gleicht rund zwei Drittel mehr Ausgabe nicht aus.
Dafür gibt es den Spitzenwert. Fable 5.2 erreicht in der Stufe Max 65 Punkte und liegt auf Platz 1 von 74 Modellen; der Median beträgt 40, Fable 5.1 kam in der Stufe Max auf 49. Bei den Kosten pro Aufgabe steht dieselbe Konfiguration auf Platz 73 von 73.
Was „Kosten pro Aufgabe“ misst
Artificial Analysis beschreibt den Wert als gewichteten Durchschnitt. Für jede Auswertung im Index werden die Kosten aus den Token-Preisen berechnet (Input, Cache-Treffer, Cache-Schreibvorgänge, Reasoning und Antwort), durch die Zahl der Aufgaben geteilt und anschließend mit dem Anteil dieser Auswertung am Index gewichtet. Reasoning-Token zählen mit. Ein Modell, das länger nachdenkt, kostet also mehr, auch wenn die Antwort am Ende kurz ausfällt.
Es handelt sich um Kosten für Benchmark-Aufgaben zu API-Preisen. Deine eigenen Aufgaben können leichter oder schwerer sein. Lies die Zahl deshalb als Vergleich zwischen Modellen und Einstellungen unter gleichen Bedingungen und nicht als Vorhersage deiner Rechnung.
Wie die Effort-Stufe die Rechnung verändert
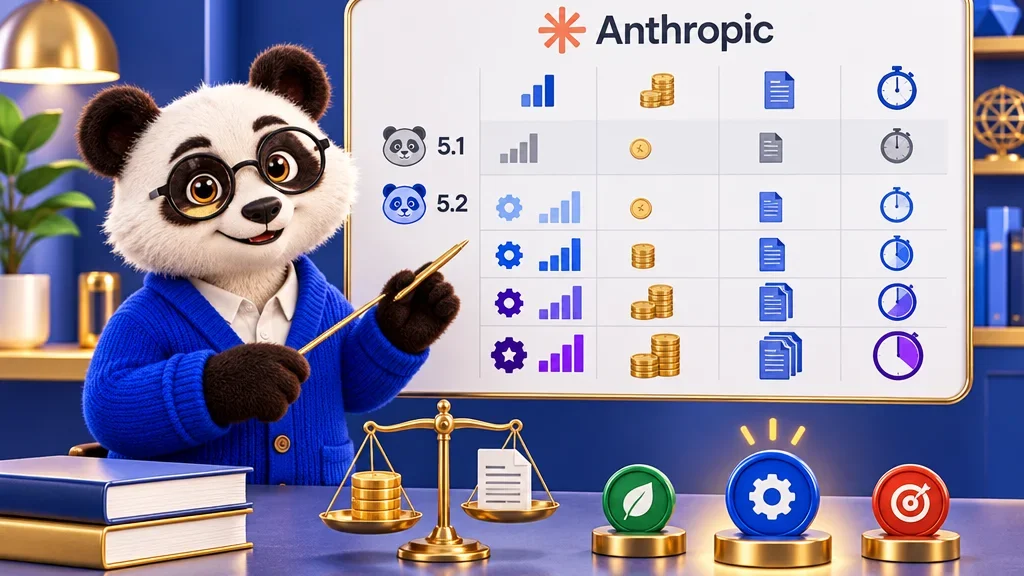
Effort ist die Einstellung, die festlegt, wie viel das Modell vor der Antwort nachdenkt. Artificial Analysis führt Fable 5.2 für jede Stufe einzeln, und die Unterschiede sind groß. In der Stufe Medium erreicht das Modell 56 Punkte für 3,80 US-Dollar pro Aufgabe und braucht 8,1 Minuten pro Aufgabe. In der Stufe High sind es 62 Punkte für 9,08 US-Dollar und 17,5 Minuten. Bei xhigh bleibt der Wert bei 62, während die Kosten auf 14,83 US-Dollar und die Zeit auf 26,1 Minuten steigen. Max bringt 65 Punkte für 26,54 US-Dollar und 44,4 Minuten pro Aufgabe. Das Median-Modell braucht 12,8 Minuten, Fable 5.1 lag in der Stufe Max bei 22,5.
Unsere Einschätzung: mit High beginnen, Max begründen
Was folgt, ist unsere Lesart dieser Zahlen und keine Aussage einer der beiden Quellen. High liefert 62 der 65 Punkte für etwa ein Drittel der Max-Kosten und in deutlich weniger als der halben Zeit. Für die meisten Arbeiten ist das der vernünftige Ausgangspunkt. Medium ist die sparsame Wahl für Routineaufgaben: 56 Punkte bedeuten immer noch Platz 9 von 74 Modellen, bei weniger als der Hälfte der High-Kosten.
In diesem Index bringt xhigh gegenüber High mehr Kosten und Wartezeit, aber keine zusätzlichen Punkte. Wir würden die Stufe nur nutzen, wenn deine eigenen Tests einen Unterschied zeigen. Max lohnt sich, wenn ein Problem so schwer ist, dass drei zusätzliche Indexpunkte fast das Dreifache der High-Kosten aufwiegen. Passend schlägt einfach nur größer.
Eine Grenze gilt für alles hier: Es ist ein einzelner Benchmark mit eigener Aufgabenmischung. Sieht deine Arbeit anders aus, lass eine kleine Stichprobe in zwei Effort-Stufen laufen und vergleiche die Ergebnisse, bevor du ein Budget festlegst.