Ein KI-Avatar kann am Strand, auf einer Konferenzbühne oder an einer belebten Straße stehen, und trotzdem klingt seine Stimme oft, als käme sie jedes Mal aus derselben kleinen Sprecherkabine. Das Bild sagt „draußen“, der Ton sagt „Abstellkammer“. Genau diese Lücke will HeyGen mit HeyGen Voice schließen, einem eigenen Sprachmodell, das das Unternehmen am 9. Oktober 2026 gestartet hat.
Was das szenenbewusste Klonen verändert
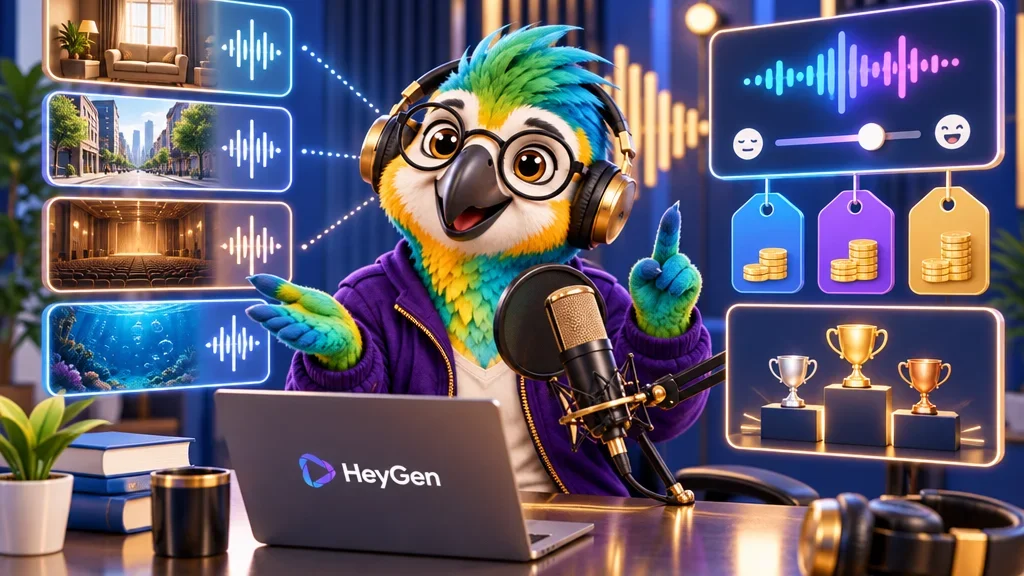
Beim Voice Cloning wird aus einer Aufnahme einer echten Person eine synthetische Stimme erzeugt, damit neue Sätze Klangfarbe, Akzent und Sprechweise behalten. Der Forschungsbericht von HeyGen beschreibt ein Modell mit drei Eingaben: eine Aufnahme deiner Stimme, ein Skript und ein Zielbild. Das Bild ist entscheidend. Im sogenannten Scene-aware-Modus werden Vortrag und Akustik an den Ort im Bild angepasst, etwa an ein Studio, eine Umgebung im Freien oder einen großen Präsentationssaal. Statt Raum und Mikrofon der Originalaufnahme in jede Szene mitzunehmen, wird der Klang an jede Szene angepasst.
Praktisch heißt das: Du musst keine getrennten Stimmstile anlegen und den Ton nicht Szene für Szene korrigieren, also Arbeit, die sonst ein Editor von Hand erledigt. Auf der Modellseite steht außerdem eine Steuerung „Set the scene“ mit drei Reglern: Tonhöhenvariation, Hintergrundpegel und Gleichmäßigkeit der Umgebung. Hören wir einmal genauer hin: Eine nahe, trockene Studiostimme und eine Stimme, die einen Saal füllt, sind zwei verschiedene Hörerlebnisse, auch wenn die Worte identisch sind.
Der Regler Expressiveness Boost
Unabhängig von der Szenenanpassung bietet HeyGen einen Expressiveness Boost. Nach Angaben des Unternehmens ist das eine eigene Schicht, die auf Hörerpräferenzen trainiert und laufend an deiner Referenzaufnahme gemessen wird; sie ergänzt Betonung, Rhythmus und Tonfall. Sie funktioniert als einzelner Regler von der Grundversion bis zur vollen Energie; auf null bekommst du das Basismodell zurück. Eine eigene Ähnlichkeitseinstellung bietet pro Satz vier Modi, von „More adaptive“ bis „Closer to original“.
Wer es nutzen kann und was es kostet
In der HeyGen-App ist eine Instant Voice aus bis zu 60 Sekunden Audio kostenlos, ebenso Stimmen in HeyGen-Videos. Ein Professional Voice Clone, für den 30 Minuten bis zwei Stunden Audio nötig sind, ist ein kostenpflichtiges Add-on ab 29 US-Dollar im Monat. Über die API kostet Text-to-Speech 30 US-Dollar pro Million Zeichen. Ein schnellerer Turbo-Modus für Instant Voices kostet die Hälfte, und laut den Release Notes ist Turbo bis zum 30. November auf geteilter Kapazität kostenlos testbar.
Wie viel die Rangliste zählt
HeyGen gibt an, das Modell sei auf Platz eins einer Voice-Cloning-Rangliste von Artificial Analysis eingestiegen. Das ist ein externer Benchmark, aber solche Ranglisten ändern sich schnell, und die meisten direkten Vergleiche auf den HeyGen-Seiten stammen aus eigenen Präferenztests des Unternehmens. Nimm den Platz als Ausgangspunkt, nicht als Urteil.
Unsere Einschätzung
Spannend ist hier nicht eine schönere Stimme, sondern eine Stimme, die zum Bild passt. Das ist eine echte Schwachstelle von Avatar-Videos, denn Zuschauer bemerken akustische Brüche, auch wenn sie sie nicht benennen können. Die Funktion ist allerdings erst wenige Wochen alt, und die veröffentlichten Belege für die Szenenanpassung stammen von HeyGen selbst. Mit schwankenden Ergebnissen ist deshalb zu rechnen, etwa mit einem Satz, der in einer klar erkennbaren Außenszene weiter nach Studio klingt. Der faire Test ist einfach: Erzeuge einen kurzen Satz in einem ruhigen Raum, einem großen Innenraum und einer lauten Außenumgebung und vergleiche alles mit Kopfhörern, bevor du dich bei Kundenprojekten darauf verlässt.