Bir yapay zekâ filminde karakterin yüzü sahneden sahneye tutarlı kalabilir; ama sesin duygusu, ritmi ve cümle vurgusu küçük farklarla kayabilir. “AI Realism Workflow the Pros Use” adlı videoda gösterilen akış, bu sorunu tek bir üretim komutuyla çözmeye çalışmak yerine ses, görüntü ve zaman bilgisini ayrı referanslar olarak düzenliyor.
İlk adım ses tasarımı. Videodaki örnekte karakter için tek bir ses seçiliyor; ardından repliğin içine “nefes nefese”, “boğazını temizler”, “daha kendinden emin” gibi kısa yönlendirmeler yerleştiriliyor. Bu yaklaşım ElevenLabs’ın da açıkladığı mantıkla örtüşüyor: Eleven v4’te köşeli parantez içindeki doğal dil ses etiketleri, cümlenin nasıl söyleneceğini yönlendirebiliyor. ElevenLabs dokümantasyonu, bu etiketlerin duygu, söyleyiş biçimi ve insanî tepkiler için kullanılabildiğini belirtiyor.
Buradaki önemli ayrım şu: ses dosyası yalnızca diyalog değildir. Daha görüntü üretilmeden, sahnenin kısa bir görsel taslağı üzerinde sesin zamanlamasını dinlemek; karakterin ne zaman konuşacağını, ne zaman susacağını ve sahnede önce hangi hareketin gerçekleşeceğini netleştirir. Bu, senaryoyu satır satır düzeltmekten çok, küçük bir animasyon planı kurmaya benzer.
Birinci yöntem: ses dosyasını doğrudan referans yapmak
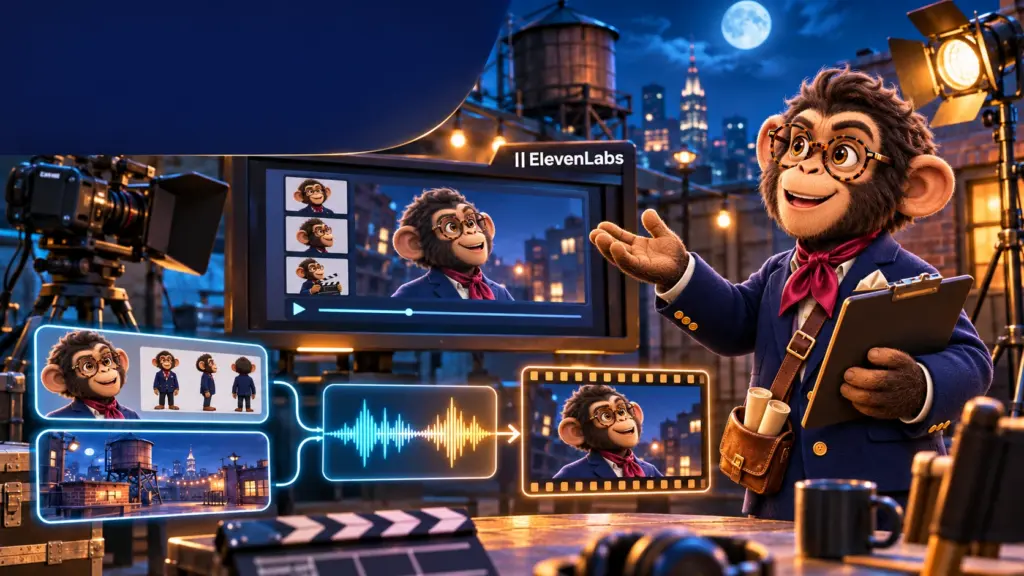
Videoda ses, karakter görseli ve mekân görseli aynı video üretimine referans olarak veriliyor. Böylece modelin önünde üç ayrı bilgi bulunuyor: kimin konuştuğu, nerede konuştuğu ve repliğin nasıl duyulması gerektiği. Bu yöntem hızlı bir başlangıç sağlıyor; ancak videodaki denemede kısa bir tekrarın artması gibi ufak farklılıklar görülüyor.
İkinci yöntem: aynı sesi görüntülü referansa dönüştürmek
Anlatıcı, aynı ses dosyasını düz siyah bir video dosyasına koyup bunu video referansı olarak kullanıyor. Kendi denemesinde bu biçimin ses vurgusunu daha yakından taşıdığını söylüyor. Yine de fikir kullanışlı: bazen bir model, ses ile görüntünün aynı zaman çizgisinde bulunmasından daha çok ipucu çıkarabilir.
Üçüncü yöntem: zaman damgalı metni de eklemek
Son katmanda, referans videodaki konuşma zaman damgalı metne dönüştürülüyor. Eğer karakter konuşmadan önce kadraja düşecekse, metindeki bütün zamanlar birkaç saniye ileri kaydırılıyor. Böylece model hem ses akışını hem de söylenen sözlerin sahne içindeki konumunu görmüş oluyor. Asıl fayda, “konuşma ne zaman başlıyor?” sorusunu belirsiz bırakmamak.
ElevenLabs, ses etiketlerinin her ses ve her ifade için aynı kesinlikte çalışmayabileceğini; seçilen sesin ve etiket biçiminin sonucu etkilediğini özellikle vurguluyor. Resmî iyi uygulama rehberi bu nedenle kendi sesiniz ve kendi metninizle test yapılmasını öneriyor. Aynı repliği kısa bir sahnede üç referans biçimiyle karşılaştırmak, hangi yöntemin daha iyi sonuç verdiğini görmeyi kolaylaştırır.
İyi bir sonuç için karakter sesini erken seçmek, repliği ses etiketleriyle prova etmek, konuşmadan önceki hareket için zaman bırakmak ve her yeni yöntemi aynı sahnede denemek yeterli bir başlangıç noktasıdır. Küçük ayrıntı, büyük fark: Ses, sahne bittikten sonra eklenen bir katman değil; sahnenin temposunu kuran referanslardan biridir.