Eine Figur kann von Einstellung zu Einstellung gleich aussehen – und dennoch anders klingen. Mal verschiebt sich die Betonung, mal das Tempo, mal taucht ein Wort zu oft auf. Das Quellvideo „AI Realism Workflow the Pros Use“ zeigt dafür keinen einzelnen Zauberprompt, sondern einen Aufbau mit getrennten Referenzen für Stimme, Bild und Zeit.
Der Einstieg liegt bei der Sprechleistung. Für die Figur wird eine Stimme festgelegt; im Text folgen kurze Hinweise wie atemlos, räuspert sich oder selbstbewusster. Das passt zu Eleven v4: Laut ElevenLabs-Dokumentation können Audio Tags in eckigen Klammern Emotionen, Sprechweise und Reaktionen innerhalb einer Zeile steuern.
Genau deshalb lohnt sich ein Audio-first-Storyboard. Bevor ein längerer Clip entsteht, kann eine statische Szene mit der fertigen Stimme verbunden werden. Dann wird sichtbar, wann die Figur ins Bild kommt, wann sie zu sprechen beginnt und wie viel Raum eine Bewegung davor braucht.
Erster Test: eine reine Audio-Referenz
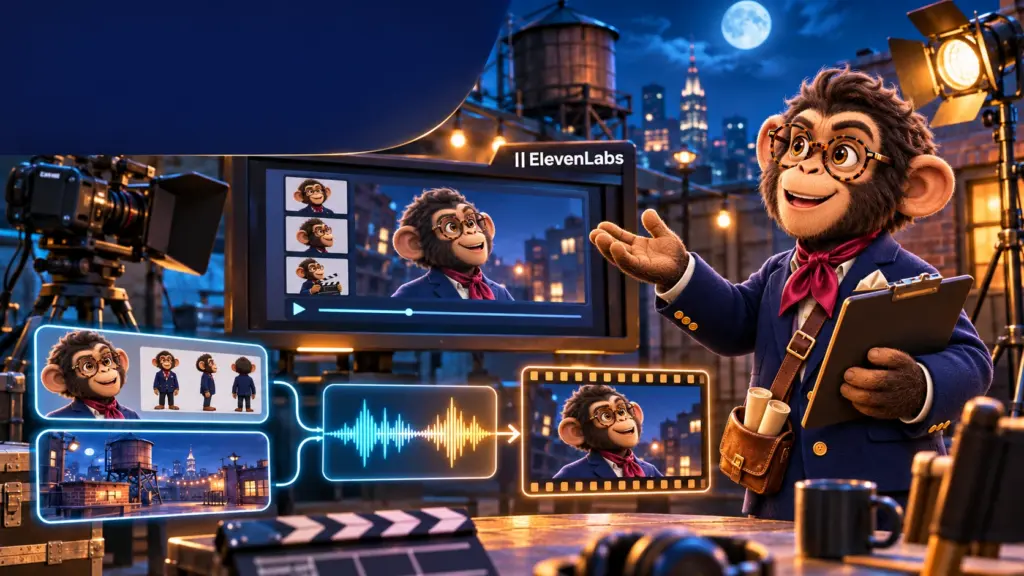
Im Video treffen Figurenbild, Set-Bild und der eingesprochene Satz in einem Videomodell zusammen. Jede Referenz beantwortet eine andere Frage: Wer spricht? Wo spielt die Szene? Wie soll die Zeile klingen? Das ist ein guter Ausgangspunkt. Die gezeigte Probe macht aber auch deutlich, dass kleine Abweichungen möglich bleiben – etwa eine zusätzliche Wiederholung am Satzanfang.
Zweiter Test: dieselbe Stimme als Video-Referenz
Danach wird dieselbe Tonspur in eine schlichte schwarze MP4-Datei gelegt und als Video-Referenz verwendet. Im Vergleich des Erstellers liegt die Sprechweise näher an der gewünschten Vorlage. Der Vergleich bleibt übersichtlich: gleiche Figur, gleiches Set, gleicher Text – nur die Form der Referenz ändert sich.
Dritter Test: Zeitmarken als zusätzliche Spur
Als dritte Ebene kommt ein zeitcodiertes Transkript hinzu. Soll die Figur zunächst landen, sich umsehen oder reagieren, werden alle Zeitmarken gemeinsam nach hinten verschoben. So erhält das Modell nicht nur die Stimme, sondern auch eine schriftliche Karte dafür, wann die jeweiligen Worte in der Einstellung liegen sollen. Die Promptarbeit kann sich dann stärker auf Bewegung und Kamerawirkung konzentrieren.
ElevenLabs weist selbst darauf hin, dass Stimme und Formulierung der Tags das Ergebnis beeinflussen. Der Leitfaden zu bewährten Methoden empfiehlt deshalb Tests mit der konkret gewählten Stimme und dem echten Anwendungsfall. Das ist der nützliche Kern dieses Ablaufs: Kurze, vergleichbare Szenen zeigen, welche Referenzform mit der gewählten Stimme besser funktioniert.
Ein früher Stimmenentscheid, ein kurzes Probestück mit der echten Dialogzeile und ein sauber gesetzter Sprechbeginn reichen oft schon aus, um spätere Szenen ruhiger zu planen. Kleine Zeitmarke, großer Unterschied.