Eine lange Datei lesen, Widersprüche finden und daraus einen brauchbaren Entwurf erstellen: Das sind mehrere Arbeitsschritte. Gemini 4 Argon ist für solche längeren Aufgaben gedacht. Für die Auswahl zählen deshalb die konkrete Aufgabe, der gewählte Zugang und der Platz, den das Modell für seine Antwort benötigt.
Für welche Aufgaben ist Argon gedacht?
Google stellte Argon am 30. September 2026 mit dem Schwerpunkt auf langen, mehrstufigen Aufgaben vor. Dazu gehören Programmierung, Dokumentenanalyse sowie Wissensarbeit in Recht und Finanzen. Die beschriebenen Fähigkeiten sind Angaben des Herstellers. Eine klare Aufgabenstellung und die Bewertung des Ergebnisses bleiben Teil des Ablaufs.
Welche Zugänge und API-Preise gibt es?
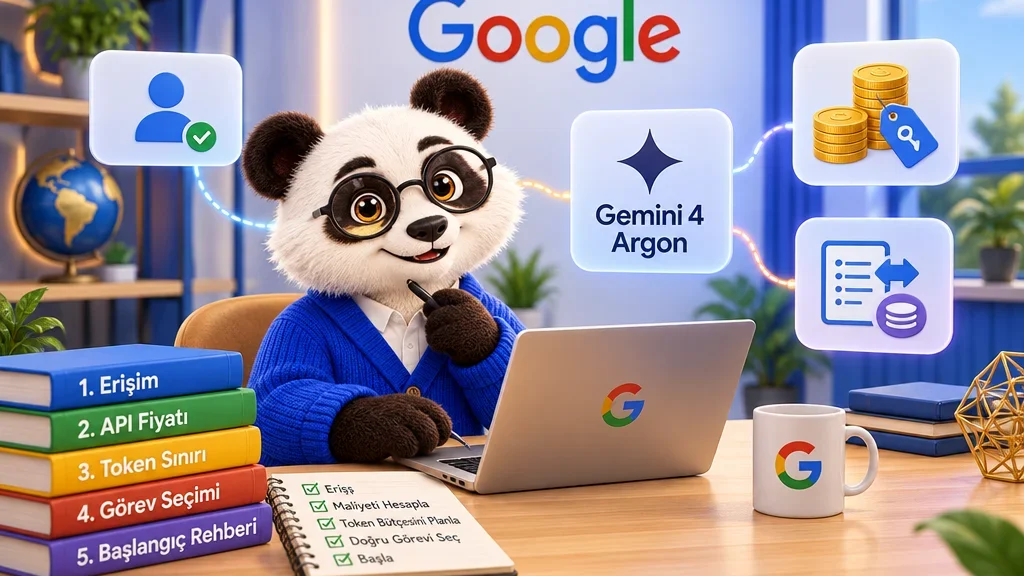
Die Mitteilung von Google Cloud vom 13. Oktober nennt Gemini for business im Web, auf dem Desktop und mobil. Entwickler erhalten Zugang über die Gemini-Plattform-API, Google AI Studio und Antigravity; die Modellkennung lautet gemini-4-argon. Diese Wege bilden kein einheitliches Abonnement: Maßgeblich sind Konto und Bedingungen des jeweiligen Dienstes.
Die angekündigten API-Einführungspreise gelten bis zum 30. November 2026: 2 US-Dollar je Million Eingabe-Token und 10 US-Dollar je Million Ausgabe-Token. Danach nennt Google Standardpreise von 4 beziehungsweise 20 US-Dollar. Gemeint sind API-Verarbeitungskosten, keine Preise für ein Chat-Abonnement.
Warum teilen sich Ein- und Ausgabe eine Million Token?
Ein Token ist eine kleine Verarbeitungseinheit des Modells und entspricht nicht einfach einem Wort. Laut technischen Unterlagen gilt ein gemeinsames Limit von 1.048.576 Token. Eingabe, internes Nachdenken, Werkzeugaufrufe und Antwort beanspruchen denselben Platz. Eine umfangreiche Eingabe lässt somit weniger Raum für die Ausgabe.
Für eine einzelne Vordergrundanfrage gilt zusätzlich eine Ausgabegrenze von 65.536 Token bei Streaming beziehungsweise 32.768 bei direkten HTTP-Anfragen ohne Streaming. Längere Ausgaben benötigen den dokumentierten Fortsetzungsmechanismus. Das gesamte Kontextfenster ist deshalb nicht mit der Antwortlänge jeder einzelnen Anfrage gleichzusetzen.
Wie setzt du die erste Aufgabe auf?
Wähle Argon in der passenden Oberfläche und verlange ein konkretes Ergebnis, etwa Widersprüche in einem Dokument samt Belegstellen. Für die API richtest du die Authentifizierung ein und verwendest ein aktuelles Google Gen AI SDK. Als Denkstufen sind LOW, MEDIUM und HIGH vorgesehen. Der ältere Parameter thinking_budget und die Einstellung MINIMAL führen zu Fehlern.
Die Modellkarte nennt mögliche erfundene Angaben, langsame Antworten und Zeitüberschreitungen. Mein erstes Auswahlkriterium wäre daher ein überprüfbares Ergebnis, nicht eine möglichst lange Antwort. Beschreibe die gewünschte Ausgabe und gleiche sie mit dem Originaldokument ab. Das gemeinsame Budget spricht ebenfalls dafür: Unnötige Dateien belegen Raum, der für die Verarbeitung und Antwort zur Verfügung stehen könnte.