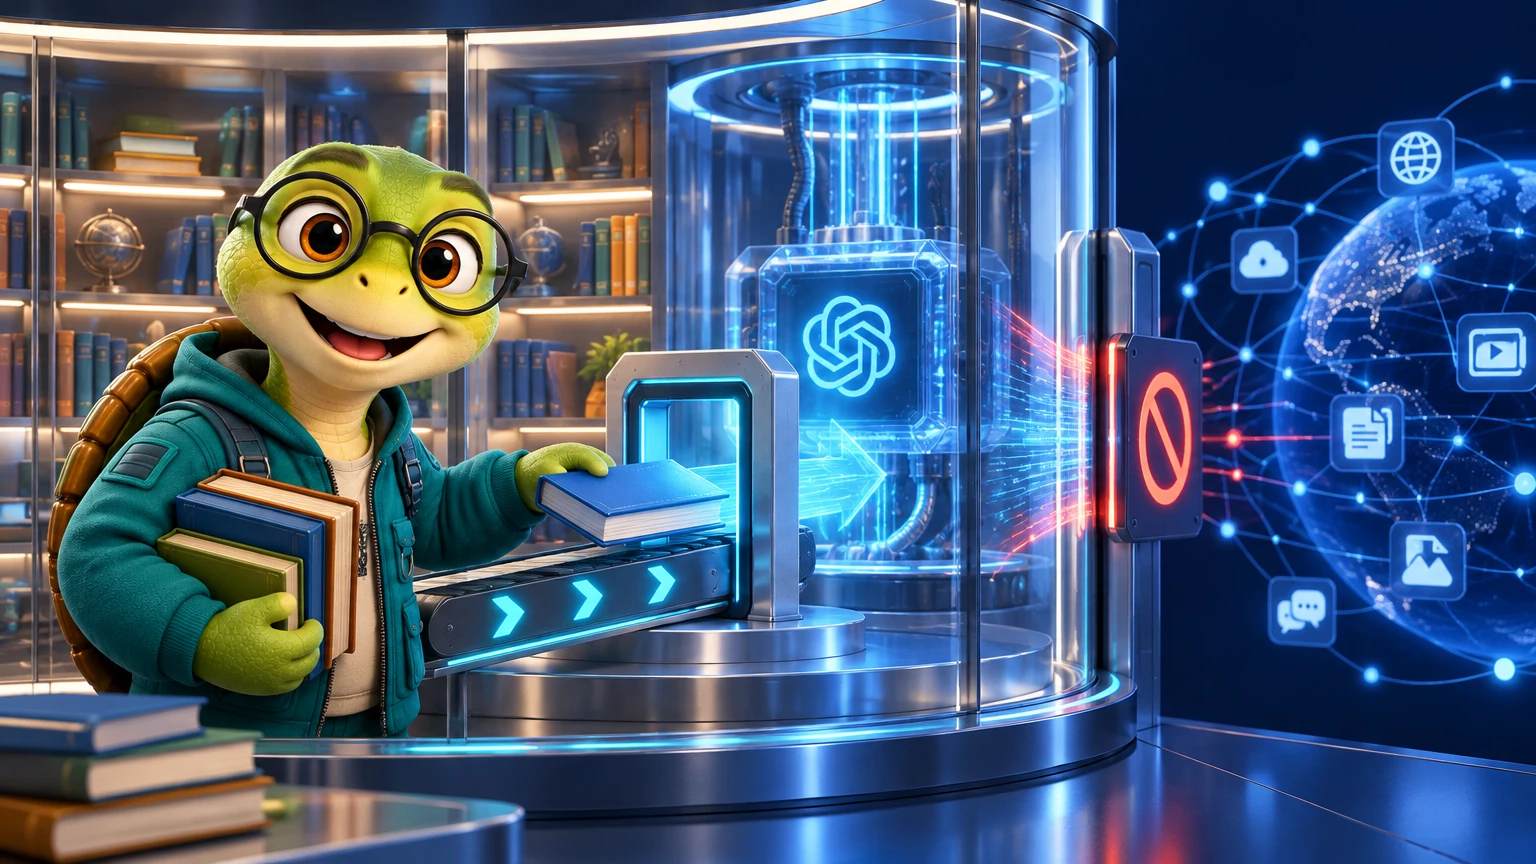
Ein Modell kann Informationen aus dem Web nutzen, ohne während seiner Arbeit mit dem offenen Internet verbunden zu sein. Auf diesem Prinzip baut OpenAI die überarbeitete Umgebung für das Training und die interne Bewertung seiner fortgeschrittensten Modelle auf. Die Beschreibung vom 23. Oktober trennt den Zugang zu Wissen vom Zugang zu externen Systemen.
Es geht um die Entwicklungsumgebung
In solchen Forschungsumgebungen schreiben Modelle Code, durchsuchen Material und erproben Lösungswege. Welche Ressourcen dabei erreichbar sind, legt die umgebende Infrastruktur fest. Die Veröffentlichung behandelt diese interne Arbeit und beschreibt keine neue Einstellung für normale ChatGPT-Unterhaltungen.
Die Quellen kommen in den abgegrenzten Bereich
Für die sogenannte „offline world“ werden Webinhalte vorab gesammelt und durchsuchbar gemacht. Das Modell kann darin recherchieren. Eine Verbindung zum ursprünglichen Webserver oder zu einem anderen externen Dienst bleibt eine gesonderte Berechtigung. Lesen und nach außen handeln werden dadurch technisch getrennt.
Mehrere Ebenen greifen ineinander
OpenAI nennt Netzbeschränkungen, isolierte Rechenumgebungen, Überwachung und Kontrollen in der Cloud-Infrastruktur. Red-Team-Agenten untersuchen unter anderem Wege ins Internet, Ausbrüche aus Arbeitsumgebungen und unerlaubte Kommunikation zwischen Agenten.
Nach einem Vorfall mit einer fehlerhaften DNS-Konfiguration im September hatte das Unternehmen Training und Bewertung seiner leistungsfähigsten Modelle unterbrochen. Nach zusätzlichen Maßnahmen und Prüfungen wurden Reinforcement Learning und interne Modellnutzung laut OpenAI am 1. Oktober wieder aufgenommen.
Theos Einordnung
Die Kontrolle bleibt greifbar, wenn Berechtigungen zur Aufgabe passen. Wer Dokumente auswerten soll, braucht dafür nicht automatisch die Möglichkeit, Daten an fremde Dienste zu senden. Diese Trennung macht eine Arbeitsumgebung verständlicher: Informationszugang und externe Aktionen lassen sich jeweils gezielt freigeben und untersuchen.