Transkripte mit Sprechertrennung
Digitale Profis stellt Voxtral 3 als erneuerte Sprachmodellfamilie von Mistral vor. Dazu gehören die Transkription von Aufnahmen, die Unterscheidung verschiedener Sprecher, eine Echtzeitvariante und ein eigenes Modell für die Sprachausgabe. Es handelt sich damit um verschiedene Bausteine und nicht nur um eine einzelne Transkriptionsfunktion. Der Kanal beschreibt Spracherkennung in rund 50 Sprachen sowie Werkzeuge, mit denen gesprochene Gespräche in Softwareabläufe eingebunden werden können.

Begriffe als zusätzlicher Kontext
Vor einer Audioaufgabe können relevante Begriffe mitgegeben werden. Produktnamen und spezielles Fachvokabular stehen dadurch als Kontext zur Verfügung, wenn sie voraussichtlich im Gespräch vorkommen. Die Funktion greift eine praktische Schwierigkeit bei Transkripten auf: Ein allgemeines Gespräch stellt andere Anforderungen als eine Aufnahme voller unbekannter Namen. Neben den Modellen zur Erkennung liefert Mistral auch ein SDK, mit dem Entwickler eigene Sprachagenten aufbauen können.
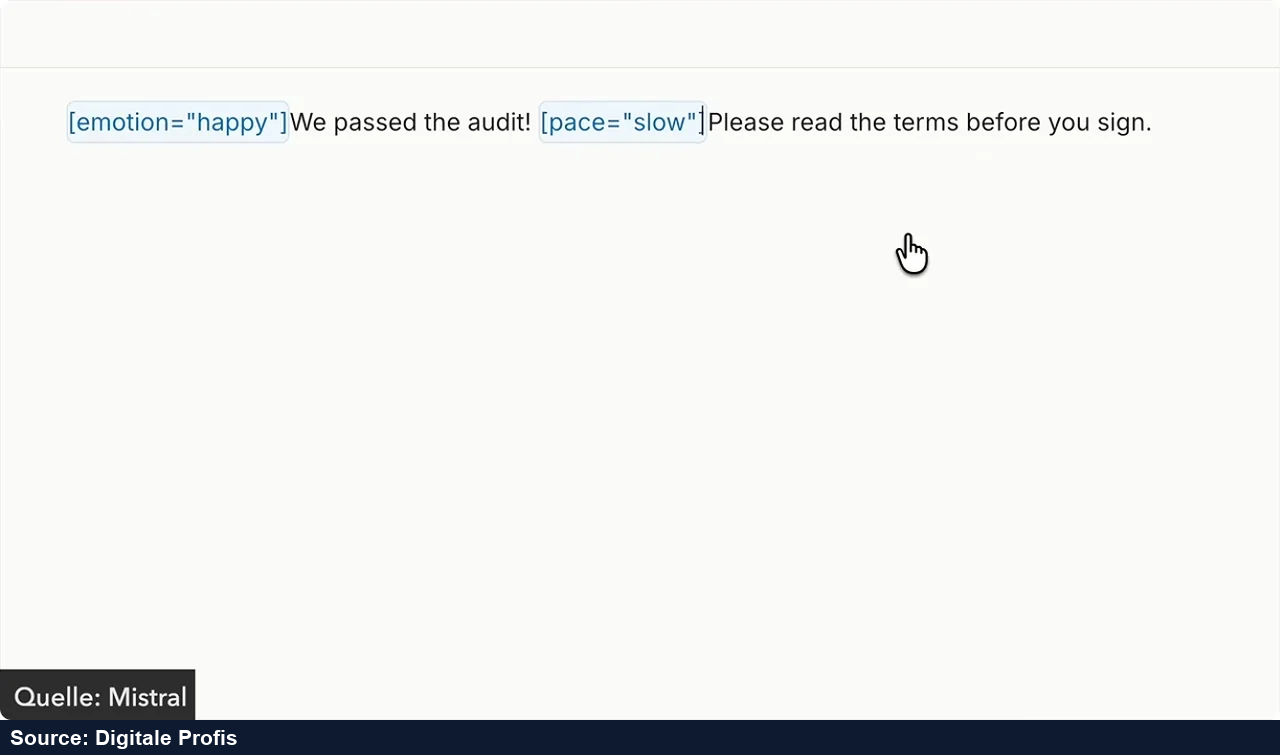
Vom Gespräch zum Werkzeug
Das SDK verbindet Zuhören und Sprechen mit einem Sprachmodell und Softwarewerkzeugen. Als Beispiel nennt der Kanal einen möglichen telefonischen Assistenten, der während des Gesprächs einen freien Termin sucht und eine Buchung vorbereitet. Das Beispiel verbindet eine gesprochene Anfrage mit einer Abfrage in angebundener Software und einer vorbereiteten Aktion. Mistral bietet eine europäisch gehostete API sowie den Betrieb auf eigener Infrastruktur an. Unternehmen können damit zwischen unterschiedlichen Verarbeitungsumgebungen wählen.