Konuşmacıları ayıran ses dökümleri
Digitale Profis, Voxtral 3’ü Mistral’ın yenilenen ses modeli ailesi olarak tanıtıyor. Ailede kayıtları metne dönüştüren modeller, farklı konuşmacıları ayırma özelliği, gerçek zamanlı bir seçenek ve ses üretimi için ayrı bir model bulunuyor. Dolayısıyla konu tek bir ses dökümü işlevinden değil, farklı görevleri üstlenen bileşenlerden oluşuyor. Kanal, yaklaşık 50 dilde konuşma tanımayı ve konuşmaların yazılım süreçlerine bağlanmasını öne çıkarıyor.

Özel terimler önceden verilebiliyor
Bir ses görevinin öncesinde ilgili kelimeler sisteme iletilebiliyor. Görüşmede geçmesi beklenen ürün isimleri veya uzmanlık terimleri böylece ek bağlam olarak kullanılabiliyor. Bu özellik, genel bir sohbet ile çok sayıda bilinmeyen isim içeren bir kaydın aynı tanıma koşullarına sahip olmamasını ele alıyor. Mistral, ses tanıma modellerinin yanında geliştiricilerin kendi sesli ajanlarını kurabilecekleri bir SDK da sunuyor. Bu araç, ayrı bileşenleri aynı konuşma akışında buluşturuyor.
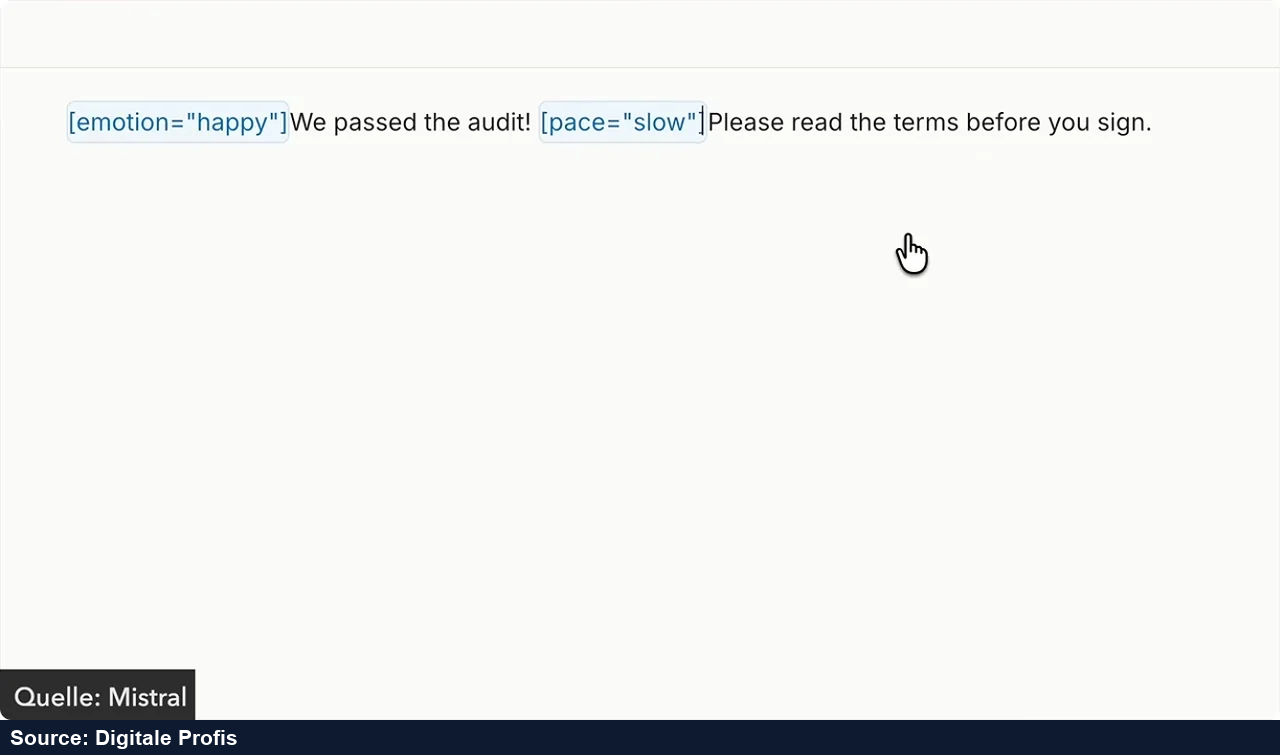
Konuşmadan yazılım işlemine
SDK; dinleme ve konuşmayı bir dil modeli ve yazılım araçlarıyla birleştiriyor. Kanal bunu, telefon görüşmesi sırasında boş bir randevuyu bulup rezervasyonu hazırlayabilecek bir asistan örneğiyle anlatıyor. Bu örnekte sözlü talep, bağlı bir yazılımda yapılan sorgulama ve hazırlanan işlem aynı konuşmada buluşuyor. Mistral, Avrupa’da barındırılan API erişiminin yanında kurumun kendi altyapısında çalıştırma seçeneği sunuyor. Şirketler böylece sesin işleneceği ortam konusunda farklı kurulum yollarını değerlendirebiliyor.