Der Linux-Kernel steckt in Cloud-Servern, Android-Smartphones und Supercomputern gleichermaßen. OpenAI berichtet, dass ein einziger automatisierter Scan dieses Kernels funktionierenden Exploit-Code für 948 verschiedene Sicherheitslücken hervorgebracht hat. Die Zahl ist groß, und es lohnt sich, genau hinzusehen. Welche Tür öffnen wir hier?
Was wurde angekündigt?
Am 5. November 2026 hat OpenAI GPT-6 Cyber vorgestellt, ein auf Cybersicherheit spezialisiertes Modell. Es ist darauf trainiert, Schwachstellen zu finden, ihre Ausnutzbarkeit zu prüfen und Patches vorzuschlagen. Laut OpenAI erreicht das Modell im Test ExploitGym, der misst, ob ein Modell eine bestimmte Lücke auf einem entfernten Ziel ausnutzen kann, 48,5 Prozent. Der Vorgänger GPT-5.6 Cyber kam auf 32,1 Prozent.
Am greifbarsten ist der Teil über echte Software. Mit dem Modell haben OpenAI-Forschende in Firefox 81 bisher unbekannte Lücken mit hohem Schweregrad gefunden; Mozilla hat für viele davon bereits Korrekturen veröffentlicht. Im Linux-Kernel wurden 1.724 Lücken reproduziert und für 948 davon funktionierende Exploits entwickelt. Nach Absprache mit der Linux-Community hat OpenAI nach eigenen Angaben 304 kritische Funde samt Patch-Vorschlägen an die Maintainer gemeldet.
Was genau wurde in Linux gefunden?
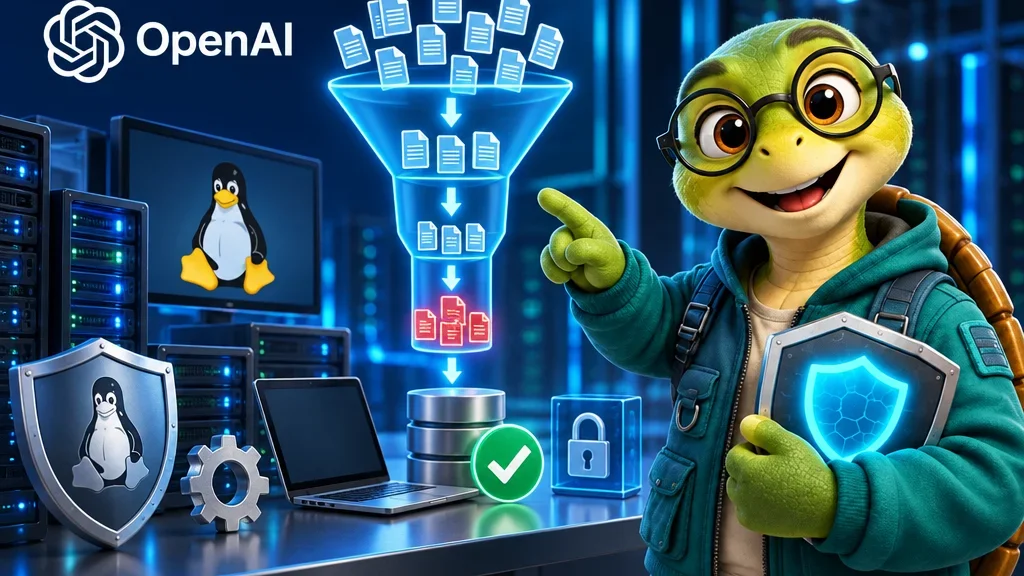
Die Details stehen in einem OpenAI-Forschungsbeitrag vom 4. November. Der Scan lief Mitte Oktober 2026 auf dem damals aktuellen Master-Zweig des Kernels. Die Zahlen werden wie in einem Trichter kleiner. Zuerst entstanden 2.308 mögliche Funde. Davon ließen sich 1.724 in isolierten virtuellen Maschinen tatsächlich reproduzieren, also rund 74,7 Prozent. Laut OpenAI lag die Analyse des Modells nur in 3,1 Prozent der Fälle falsch.
Danach erzeugten die Agenten 1.169 funktionierende Exploits zur lokalen Rechteausweitung. Lokale Rechteausweitung (LPE) heißt: Wer bereits ein normales Konto auf einem System hat, kann sich zum Administrator, also zu root, machen. Nachdem Exploits aussortiert waren, die auf derselben Lücke beruhten, blieben 948 eindeutige Schwachstellen mit je einem eigenen Patch-Vorschlag. Das ist die Zahl aus der Schlagzeile.
Wie funktioniert die automatisierte Pipeline?
OpenAI beschreibt eine Pipeline mit fünf Stufen. Scout-Agenten wählten die sicherheitsrelevanten Teile des Kernels aus: 5.034 Ziele mit rund 2,8 Millionen Zeilen, etwa 7 Prozent des gesamten Codes. Analyse-Agenten prüften diese Ziele in 12 Stunden und lieferten mögliche Funde. Validierungs-Agenten schrieben für jeden Fund einen Proof of Concept und testeten ihn in virtuellen Maschinen mit KASAN, einem Werkzeug, das Speicherfehler erkennt.
Die Exploit-Tests liefen mit eingeschalteten Schutzmechanismen einer Standard-Distribution, darunter SMEP, SMAP und KASLR. Danach folgte die Patch-Erzeugung. Das letzte Wort hatten Menschen: Exploit, Patch und vorgeschlagener Schweregrad wurden von Hand geprüft, bevor etwas an die Maintainer ging.
Der Beitrag enthält auch eine ehrliche Lektion. In frühen Durchläufen hatten 20 von 200 gemeldeten erfolgreichen Exploits root über eine andere Zero-Day-Lücke erreicht als die zugewiesene. OpenAI hat daraufhin eine unabhängige Prüfung eingebaut, die bestätigt, dass jeder fertige Exploit wirklich seine Ziellücke nutzt.
Was hat das gekostet, und im Vergleich wozu?
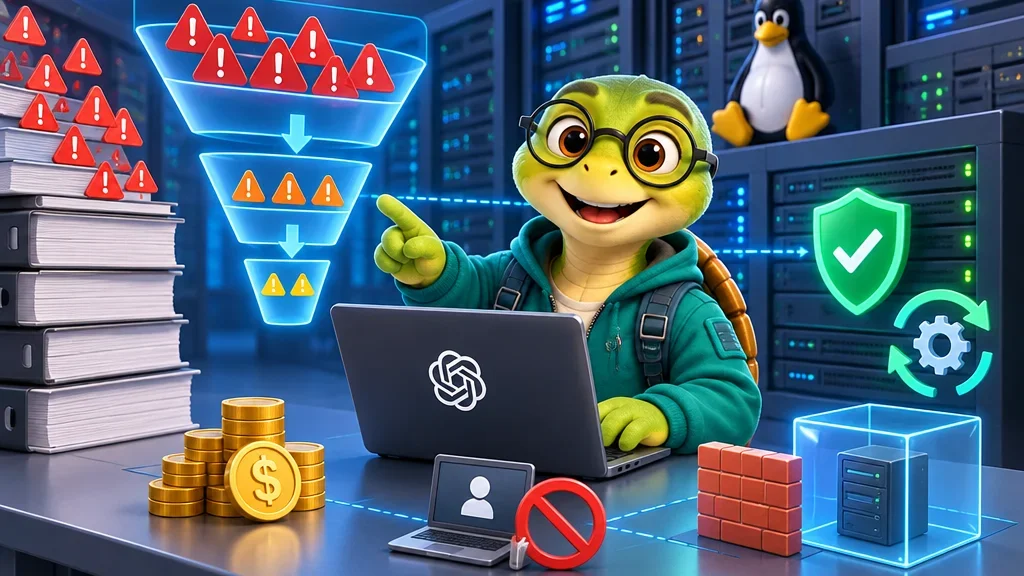
Der gesamte Durchlauf kostete 1.213.430 Dollar an API-Guthaben, also rund 1.279 Dollar pro Exploit. Im Juli 2026 hatte GPT-5.6 Sol mit demselben Aufbau 166 eindeutige Lücken für 513.690 Dollar gefunden. Das neue Modell lieferte mehr als das Fünffache bei etwa 2,4-fachen Kosten.
OpenAI vergleicht die Ausgaben auch mit Bug-Bounties. Pwn2Own und TyphoonPWN zahlten in der Vergangenheit 20.000 bzw. 70.000 Dollar für Linux-LPE-Exploits. Auf 948 Exploits übertragen ergibt das einen hypothetischen Wert von 18,9 bis 66,3 Millionen Dollar. Das Unternehmen betont, dass die genannten Kosten eher eine Obergrenze sind und mit besserer Technik sinken könnten.
Was bedeutet das für alle, die Server betreiben?
Zuerst eine ruhige Einordnung: Alle diese Lücken sind lokal. Ein Angreifer braucht zuerst einen Zugang als normaler Nutzer; es sind keine Fehler, die sich allein über das Internet verbreiten. Trotzdem ist OpenAIs eigene Schlussfolgerung deutlich: Auf einem System ohne die neuesten Patches sollte der Zugang zu einem Konto mit geringen Rechten für einen gut ausgestatteten Angreifer praktisch wie root-Zugang gelten.
Die Linux-Maintainer reagieren schnell. Als Scan und manuelle Prüfung nach 10 Tagen abgeschlossen waren, waren 61 der Lücken bereits im Hauptprojekt gepatcht, für 43 lagen Patches in Vorbereitung, und 299 wurden öffentlich diskutiert. Der praktische Check daraus ist einfach: Kernel-Updates nicht aufschieben und Prozesse mit Isolationsschichten wie Firecracker oder gVisor begrenzen.
Wer kann das Modell nutzen, und was schützt vor Missbrauch?
GPT-6 Cyber ist nicht öffentlich. Es steht zunächst einer ausgewählten Gruppe freigegebener Daybreak-Red-Kunden über die API und Codex zur Verfügung; OpenAI will den Zugang bald auf alle Daybreak-Red-Kunden ausweiten. Im eigenen Preparedness Framework stuft OpenAI das Modell im Bereich Cybersicherheit als Kritisch ein, die höchste Stufe; GPT-5.6 Cyber lag bei Hoch.
Zu den Schutzmaßnahmen gehören eine standardmäßige IP-Allowlist für den Daybreak-Red-API-Zugang, eine Überwachung, ob Aktionen innerhalb der erteilten Berechtigung bleiben, und Sperren für riskante Hilfe gegen kritische Infrastruktur. In einem Scope-Test vermied das Modell Angriffe auf Dienste außerhalb des Auftrags in 99,93 Prozent der Durchläufe ohne zusätzlichen Sicherheits-Prompt und in 100 Prozent mit ihm.
Einschätzung
Entscheidend ist hier weniger die Zahl 948 selbst als das, was sie umgibt. OpenAI findet nicht nur Fehler, sondern reproduziert und nutzt jeden davon aus, um ihn einzuordnen, und schlägt dann eine Korrektur vor. Das trifft genau die Frage, mit der Maintainer am meisten kämpfen: Welcher Bericht ist echt, und welcher ist dringend? Gleichzeitig stammen alle Zahlen bislang aus OpenAIs eigenen Messungen und sind nicht unabhängig geprüft. Meine Schlussfolgerung: Wenn derselbe Aufbau innerhalb weniger Monate fünfmal produktiver wurde, sinken die Kosten der Fehlersuche für Angreifer ebenso wie für Verteidiger. Dann ist die stärkste Verteidigung kein neues Werkzeug, sondern die Gewohnheit, Updates schnell einzuspielen.